

Lokale KI im Mittelstand: Was geht, was nicht, was es braucht
Sprachmodelle auf eigener Hardware sind 2026 für viele betriebliche Aufgaben leistungsfähig genug. Wir zeigen, welche Modelle und Hardware passen, wie LibreChat sie nutzbar macht und wann Cloud, lokaler Betrieb oder eine hybride Lösung sinnvoll sind.
Stand: 3. November 2026
Lokale Sprachmodelle lassen sich inzwischen auf Hardware betreiben, die für mittelständische Unternehmen realistisch ist. Für viele Aufgaben reicht ihre Leistung aus. Ob sich der lokale Betrieb lohnt, hängt vom Schutzbedarf der Daten, der Nutzungsintensität und dem verfügbaren Betriebsaufwand ab.
Auf einen Blick
- Offene Sprachmodelle sind 2026 gut genug für einen großen Teil der Büroarbeit: Zusammenfassen, Entwürfe, Fragen an eigene Dokumente, Daten aus Texten ziehen.
- Für ein Team reicht oft eine Workstation mit einer guten Grafikkarte. Ein Rechenzentrum brauchen Sie dafür nicht.
- Mit Gemma 4 gibt es eine starke Modellfamilie unter Apache 2.0, also auch kommerziell ohne Kleingedrucktes nutzbar.
- LibreChat liefert eine Oberfläche, die sich für Ihr Team wie ein gewohnter KI-Chat anfühlt, nur eben bei Ihnen im Haus.
- Wer KI nur gelegentlich nutzt, fährt mit einer Cloud-API oft günstiger. Entscheidend sind der konkrete Anwendungsfall und seine Anforderungen.
Warum überhaupt lokal?
Drei Gründe begegnen uns immer wieder:
- Die Daten sollen im Haus bleiben. Personalakten, Verträge, Konstruktionsunterlagen, Kundendaten. Bei vielen Unternehmen ist das kein Wunsch, sondern eine Vorgabe. Lokal macht eine Lösung nicht automatisch datenschutzkonform, aber der Rahmen wird deutlich überschaubarer: Es gibt keinen externen Anbieter, dessen Verarbeitung Sie prüfen müssen.
- Planbare Kosten. Es gibt keinen Preis pro Anfrage und keine steigende API-Rechnung bei wachsender Nutzung. Dafür fallen Anschaffung, Strom und Betriebsaufwand an. Diese Kosten gehören in die Kalkulation.
- Kontrolle über Versionen. Bei Cloud-Diensten kann der Anbieter ein Modell austauschen oder aktualisieren. Lokal legen Sie selbst fest, wann eine neue Modellversion in Betrieb geht.
Wo lokale Modelle heute stehen
Der Abstand zwischen offenen Modellen und den besten Cloud-Modellen ist in den letzten zwei Jahren deutlich kleiner geworden. Verschwunden ist er nicht. Spürbar wird er vor allem bei langen, mehrstufigen Aufgaben, bei denen ein Modell selbstständig planen, Werkzeuge nutzen und Zwischenergebnisse prüfen soll.
Als grobe Orientierung für das Jahr 2026:
Gut geeignet
- Zusammenfassen, Übersetzen, Entwürfe
- Fragen an eigene Dokumente (RAG)
- Klassifizieren und Extrahieren
- Code-Assistenz für Routineaufgaben
- Alles, was im Haus bleiben muss
Noch schwierig
- Lange, mehrstufige Agentenaufgaben
- Reasoning auf dem Niveau der besten Cloud-Modelle
- Lange Kontexte bei vielen gleichzeitigen Nutzern
- Aktuelles Weltwissen ohne Quellen
- Betrieb ganz ohne eigene IT
Ein pauschaler Vergleich mit dem jeweils stärksten Cloud-Modell hilft bei der Auswahl wenig. Sinnvoller ist ein Test mit konkreten Aufgaben, eigenen Beispieldaten und festgelegten Qualitätskriterien. So lässt sich prüfen, ob ein lokales Modell für den vorgesehenen Einsatz ausreicht.
Bei Fragen zu eigenen Dokumenten bestimmt häufig die Aufbereitung der Dokumente die Qualität stärker als das Modell. Ein schlecht ausgelesenes PDF liefert auch mit einem leistungsfähigen Modell keine verlässlichen Antworten.
Die Modelle: offen, kommerziell nutzbar, unterschiedlich groß
| Modellfamilie | Anbieter | Größen | Lizenz | Gut für |
|---|---|---|---|---|
| Gemma 4 | Google, 2026 | E2B, E4B, 12B, 26B-A4B, 31B | Apache 2.0 | Allrounder, mehrsprachig, Bilder, langer Kontext |
| gpt-oss | OpenAI, 2025 | 20B, 120B | Apache 2.0 | Reasoning, Werkzeugnutzung |
| Mistral Small 4 | Mistral AI, 2026 | 119B (MoE, ca. 6B aktiv) | Apache 2.0 | europäischer Anbieter, Text, Bild, Code |
| Qwen 3.x | Alibaba, 2026 | u. a. 27B | je Modell prüfen | Code, Mehrsprachigkeit |
Unser Favorit für den Einstieg ist derzeit Gemma 4. Google hat die Familie im April 2026 veröffentlicht und dabei die Lizenz auf Apache 2.0 umgestellt. Frühere Gemma-Versionen hatten eigene Nutzungsbedingungen. Laut offizieller Modellkarte reicht die Familie vom Smartphone-Modell bis zum 31B-Modell für die Workstation. Die mittleren und größeren Varianten verarbeiten bis zu 256.000 Tokens Kontext, also auch längere Dokumente am Stück.
Besonders interessant für den Mittelstand ist Gemma 4 26B-A4B. Hinter dem etwas sperrigen Namen steckt ein Bauprinzip, das wir kurz erklären müssen.
Exkurs: Was bedeutet MoE?
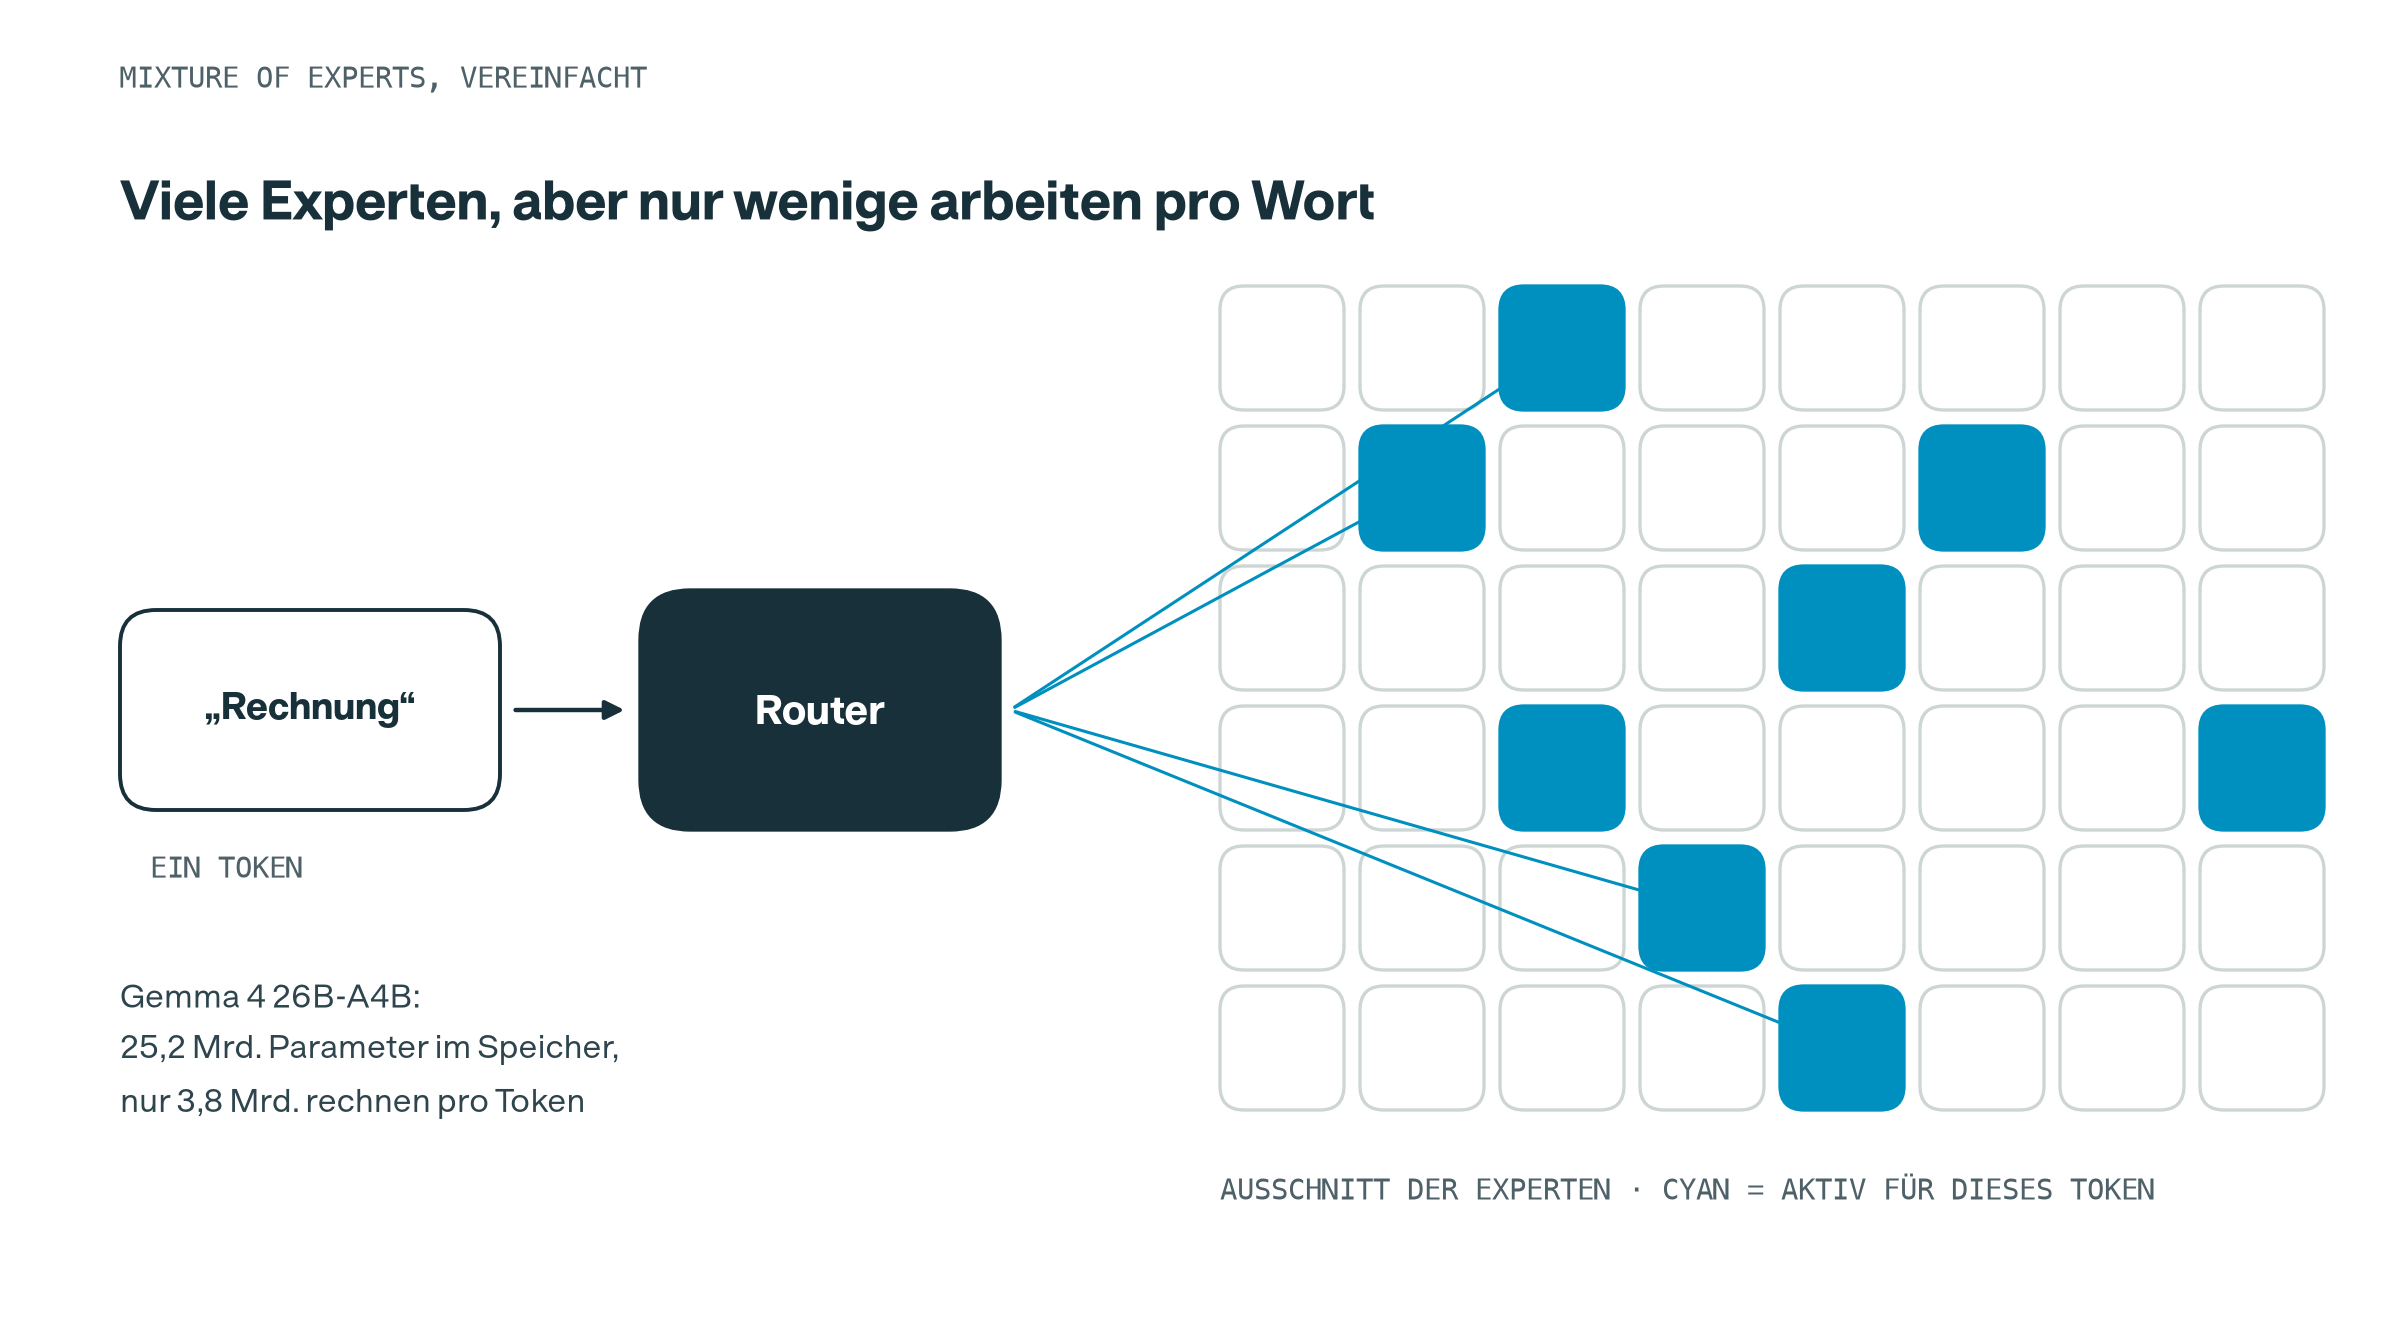
MoE steht für Mixture of Experts. Ein klassisches Sprachmodell schickt jedes Wort durch alle seine Parameter. Ein MoE-Modell zerlegt Teile des Netzes in viele kleine Experten. Ein Router entscheidet für jedes Wort, welche wenigen Experten zuständig sind. Der Rest hat Pause.
Bei Gemma 4 26B-A4B heißt das: Im Speicher liegen 25,2 Milliarden Parameter, gerechnet wird pro Wort aber nur mit 3,8 Milliarden. Das „A4B“ steht für „rund 4 Milliarden aktiv“. Die Experten sind dabei keine Fachabteilungen für Recht oder Medizin, sondern Teile des Netzes, die sich im Training spezialisieren.
Was bedeutet das praktisch?
- Qualität eher wie ein mittelgroßes Modell, weil viel Wissen im Netz steckt.
- Tempo eher wie ein kleines Modell, weil pro Wort wenig gerechnet wird.
- Aber: Der Speicher muss trotzdem das ganze Modell fassen. MoE spart Rechenzeit, nicht Grafikspeicher.
Damit verbindet das Modell kurze Antwortzeiten auf einer einzelnen Grafikkarte mit der Wissenskapazität eines deutlich größeren Netzes.
Welche Hardware wird benötigt?
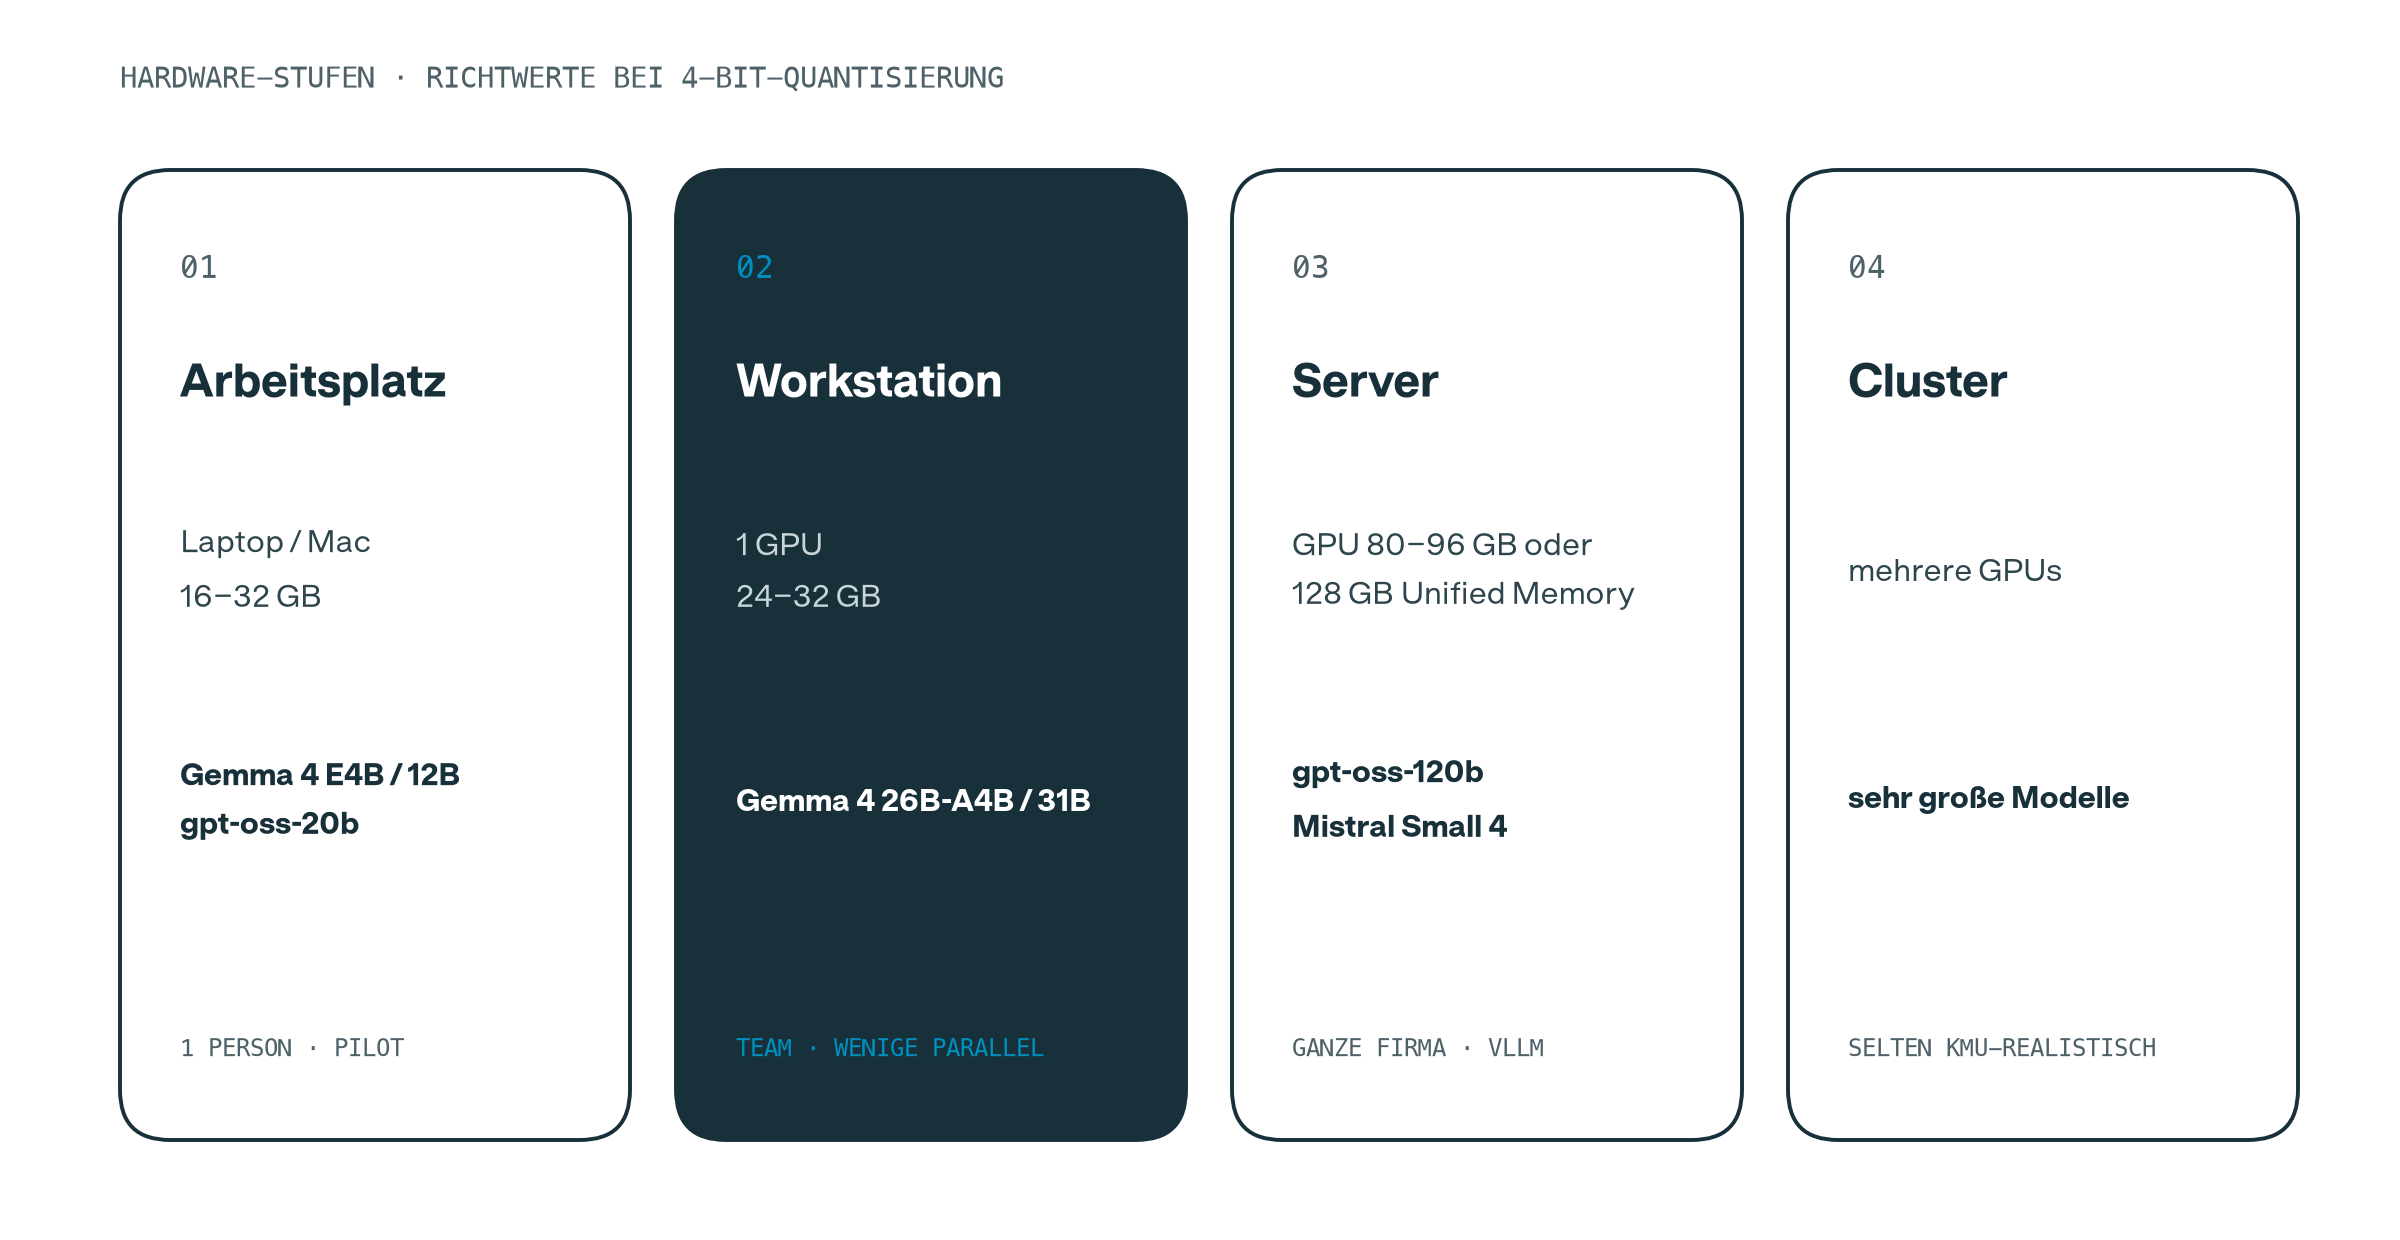
Mit sogenannter Quantisierung werden die Modelle auf grob ein Drittel bis ein Viertel ihrer ursprünglichen Größe komprimiert, bei überschaubarem Qualitätsverlust. Gemma 4 26B-A4B belegt dann etwa 16 bis 19 GB, das 31B-Modell etwa 19 bis 20 GB.
- Für einen Piloten reicht ein gut ausgestatteter Laptop oder Mac.
- Für ein Team reicht meist eine Workstation mit einer Grafikkarte mit 24 bis 32 GB Speicher. Darauf laufen Gemma 4 26B-A4B oder 31B.
- Erst wenn viele Menschen gleichzeitig arbeiten oder sehr große Modelle gefragt sind, wird ein Server mit einer großen Rechenkarte sinnvoll.
Der Engpass ist dabei häufig der Speicher für parallele Anfragen. Jede gleichzeitige Unterhaltung braucht zusätzlichen Platz, vor allem bei langen Dokumenten. Die erforderliche Kapazität sollte deshalb anhand der erwarteten Zahl gleichzeitiger Nutzer geplant werden.
Die Oberfläche: LibreChat
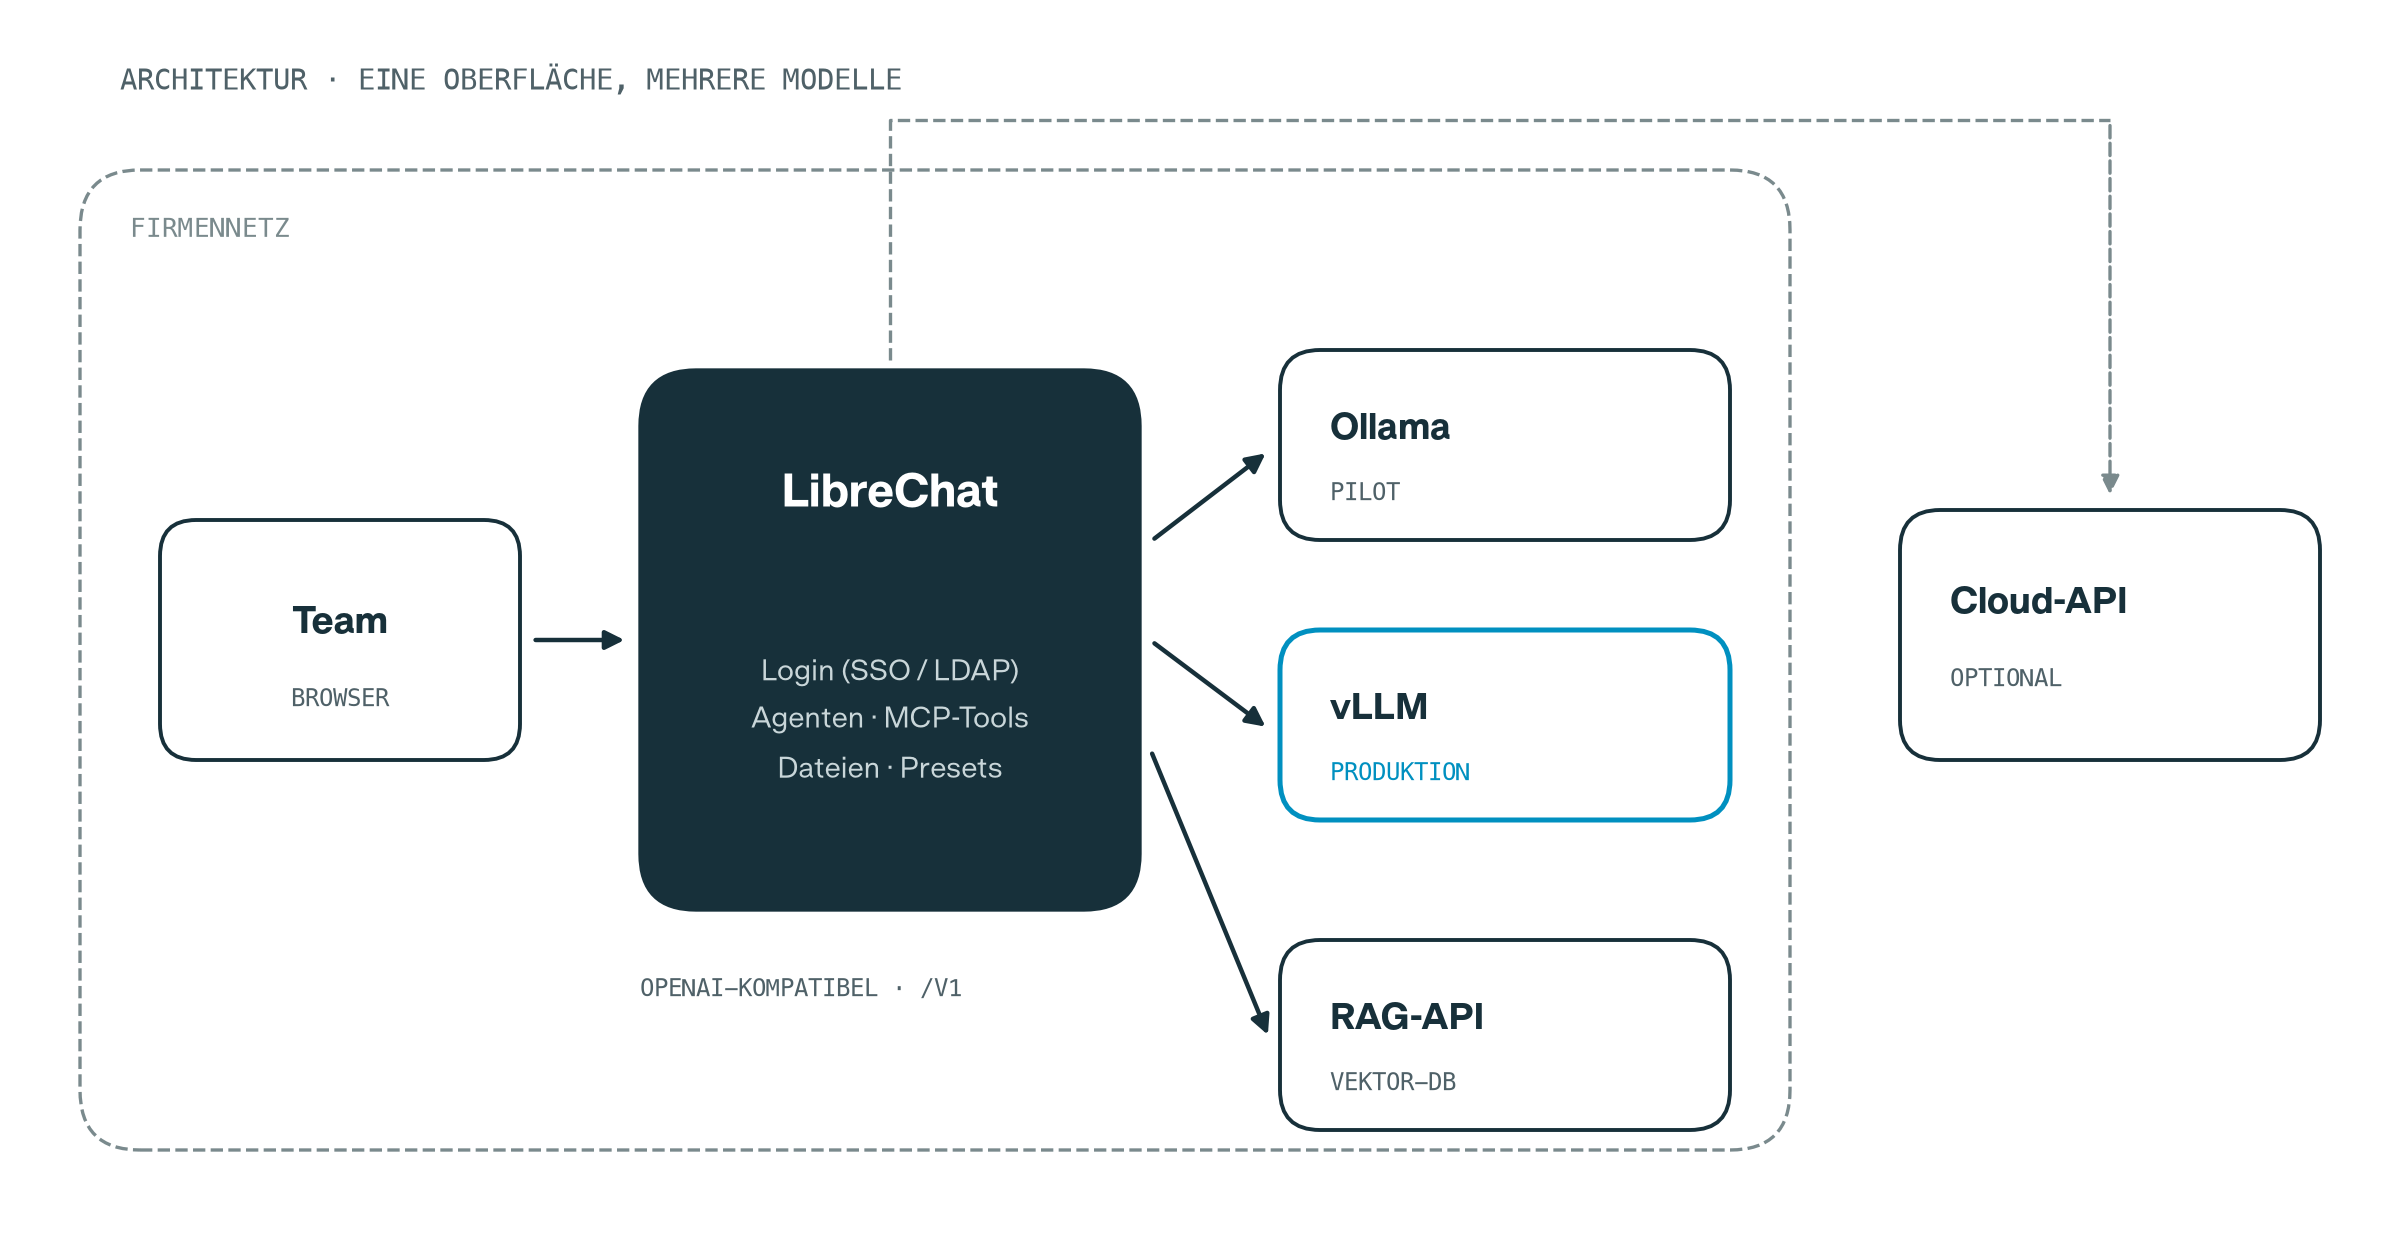
Ein Modell allein ist noch kein Werkzeug fürs Team. Es braucht eine Oberfläche mit Anmeldung, Verlauf, Datei-Upload und der Möglichkeit, eigene Assistenten zu bauen. Dafür setzen wir LibreChat ein:
- Open Source unter MIT-Lizenz, selbst gehostet per Docker.
- Eine Oberfläche für viele Modelle: lokale Modelle und, wenn gewünscht, freigegebene Cloud-Modelle nebeneinander.
- Agenten und Werkzeuge über das Model Context Protocol (MCP), Fragen an eigene Dateien über eine separate RAG-Komponente.
- Anmeldung über die bestehende Firmenumgebung (z. B. LDAP oder OpenID Connect).
Wie LibreChat als zentrale Plattform aufgebaut und betrieben wird, beschreiben wir ausführlich in unserem Beitrag LibreChat als zentrale KI-Plattform im Unternehmen.
LibreChat spricht mit den Modellservern über eine OpenAI-kompatible Schnittstelle. Für den Piloten nutzen wir Ollama, weil es schnell eingerichtet ist. Für den Produktivbetrieb eignet sich vLLM, das auf viele gleichzeitige Anfragen optimiert ist. Die Oberfläche für das Team bleibt beim Wechsel unverändert.
So sieht die Anbindung in der Konfiguration aus:
endpoints:
  custom:
    - name: "Ollama"
      apiKey: "ollama"
      baseURL: "http://host.docker.internal:11434/v1/"
      models:
        default: ["gemma4:26b"]
        fetch: true
      titleConvo: true
      titleModel: "current_model"
      modelDisplayLabel: "Lokal (Pilot)"
Ollama hat von Haus aus keine Anmeldung. Läuft LibreChat in Docker, muss Ollama für den Container erreichbar sein. Der Ollama-Port darf dabei nicht im gesamten Firmennetz verfügbar werden. Er sollte nur für LibreChat erreichbar und per Firewall abgesichert sein.
Lokal, Cloud oder hybrid? Die Entscheidungsmatrix
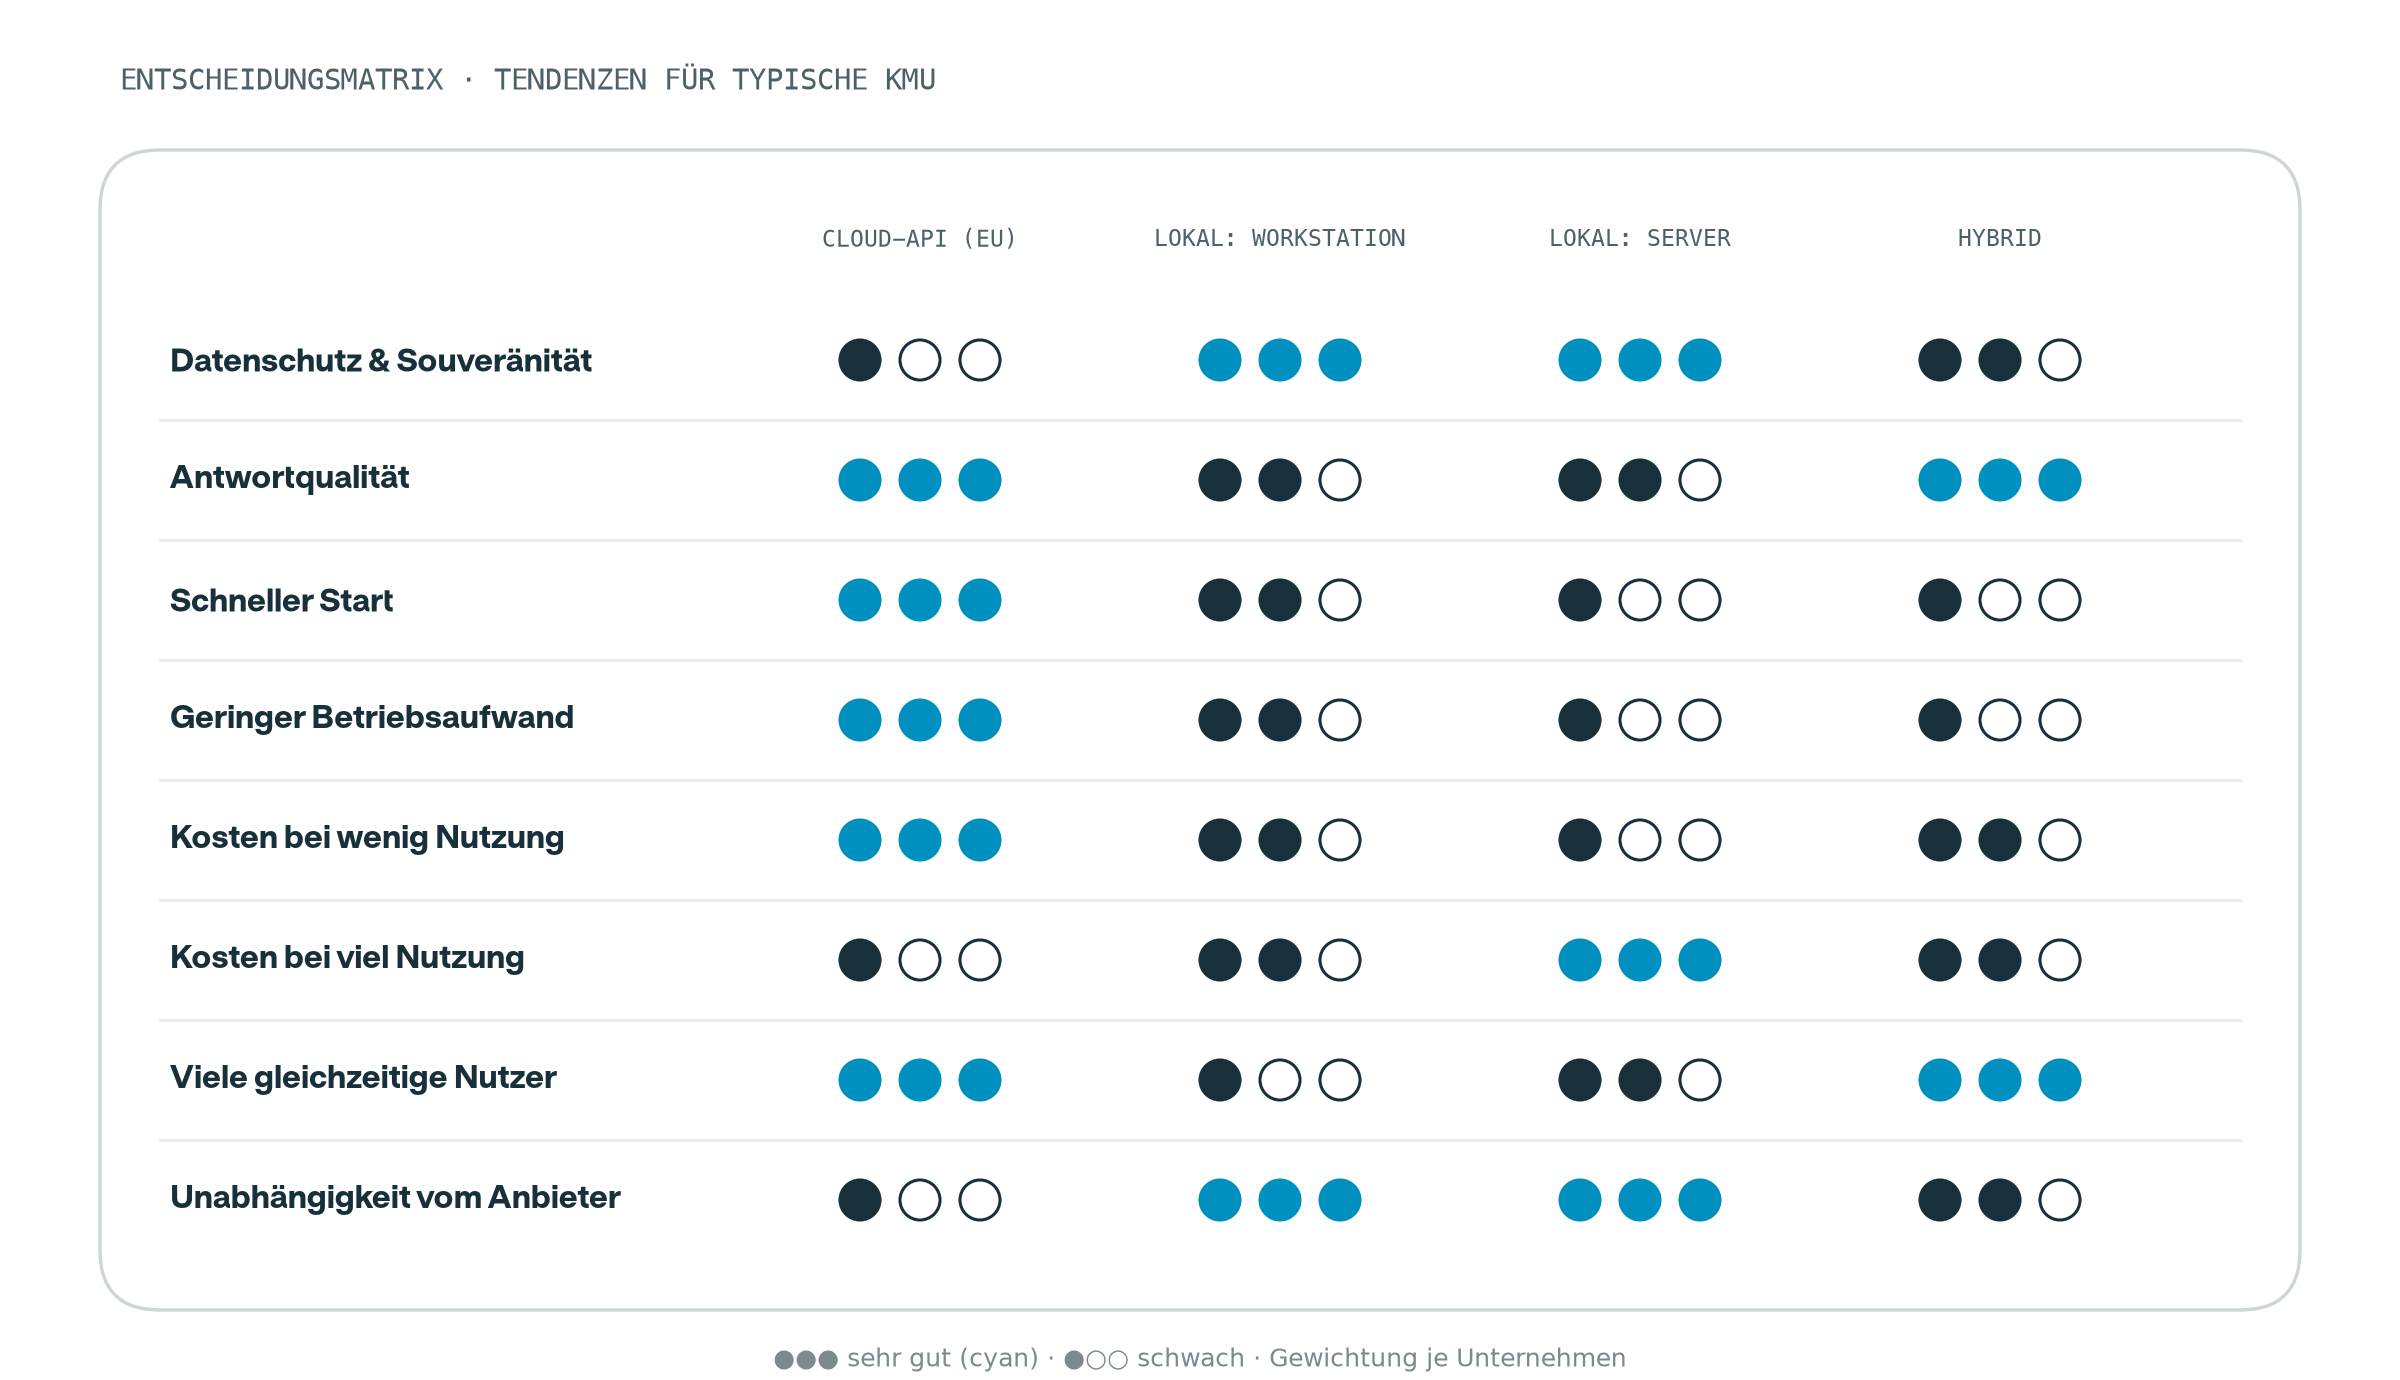
Die vier Betriebsmodelle setzen unterschiedliche Schwerpunkte:
- Cloud-API gewinnt bei schnellem Start, wenig Betriebsaufwand und geringer Nutzung. Sie verliert bei Souveränität und bei hoher, gleichmäßiger Last.
- Lokale Workstation ist der pragmatische Einstieg: souverän, überschaubar teuer, ideal für Teams.
- Lokaler Server rechnet sich bei vielen Nutzern und hoher Auslastung, braucht aber Betriebskompetenz.
- Hybrid kombiniert beides: sensible Aufgaben lokal, freigegebene Aufgaben in der Cloud. Das kann die jeweiligen Vorteile verbinden, erfordert aber klare Regeln für die Weiterleitung von Anfragen.
Entscheidend ist die Gewichtung. Wer mit sensiblen Daten arbeitet, für den ist Souveränität ein K.-o.-Kriterium. Wer vor allem schnell starten will, gewichtet anders.
Unser Fahrplan
- Use Cases festlegen. Zwei bis drei konkrete Aufgaben, dazu eigene Testfragen mit erwarteten Antworten.
- Pilot konzipieren und aufsetzen. Geeignete Hardware, Modellserver und LibreChat in einer abgesicherten Testumgebung zusammenführen.
- Messen. Stimmen die Antworten? Nutzt das Team das Werkzeug? Wie lang sind die Wartezeiten?
- Entscheiden. Server mit vLLM, Hybrid oder bewusst Cloud. Die Messergebnisse des Piloten bilden dafür die Grundlage.
- Betrieb klären. Wer aktualisiert die Modelle, wer prüft die Sicherheit, wer ist Ansprechpartner? Ohne klare Zuständigkeit wird aus dem Piloten schnell ein vergessener Rechner unter dem Schreibtisch.
Fazit
Lokale KI ist 2026 technisch ausgereift genug, um sie als kontrollierte Alternative oder Ergänzung zu Cloud-Diensten zu betreiben. Ob sie wirtschaftlich ist, entscheidet sich an Auslastung, Hardware, Qualitätsanforderungen und Betriebsmodell. Modelle wie Gemma 4 und Plattformen wie LibreChat bilden dafür eine belastbare technische Grundlage.
Nicht jede Aufgabe gehört auf die eigene Hardware, und nicht jedes Unternehmen sollte einen eigenen KI-Server betreiben. Ausschlaggebend sind Schutzbedarf, Nutzung, Qualitätsanforderungen und die vorhandene Betriebskompetenz.
Wir unterstützen Unternehmen dabei, diese Entscheidung fundiert zu treffen, die Architektur zu planen, den Piloten aufzubauen und die Ergebnisse auszuwerten. Wer die Plattform nicht selbst betreiben möchte, findet mit chat.wonk unser Managed-LibreChat-Angebot. Sprechen Sie uns an.
Quellen und weiterführende Links
- Gemma 4 Modellkarte (Google AI for Developers)
- Gemma 4: Ankündigung von Google
- Gemma 4 Technical Report (arXiv)
- Gemma 4 in der Ollama-Bibliothek
- LibreChat: Ollama anbinden
- LibreChat: vLLM anbinden
- LibreChat: Agenten
- Mistral Small 4 unter Apache 2.0
Modelle, Versionen und Lizenzen ändern sich schnell. Vor dem Einsatz bitte immer die offizielle Modellkarte prüfen.